Цена для справки. Окончательная цена — в счёте. Не публичная оферта.


Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Запросить цену
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Запросить цену
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Запросить цену
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Запросить цену
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Запросить цену
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.

Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Подборка из практичных позиций, которые удобно брать в первую очередь для быстрого запуска, теста и пилота.
2VP5U9Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
Цена для справки. Окончательная цена — в счёте. Не публичная оферта.
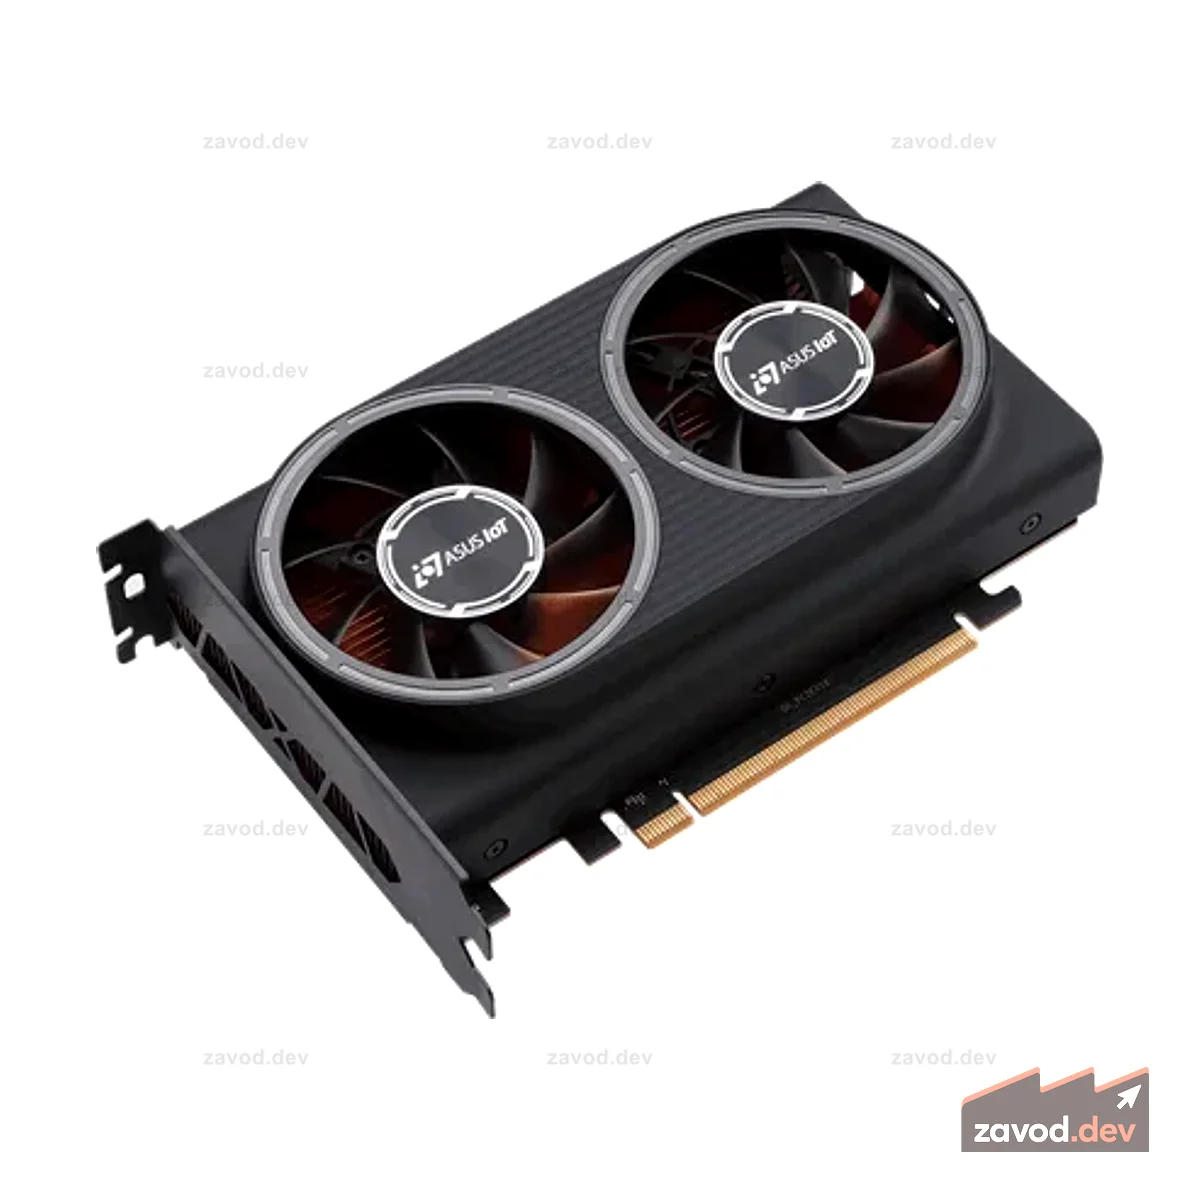
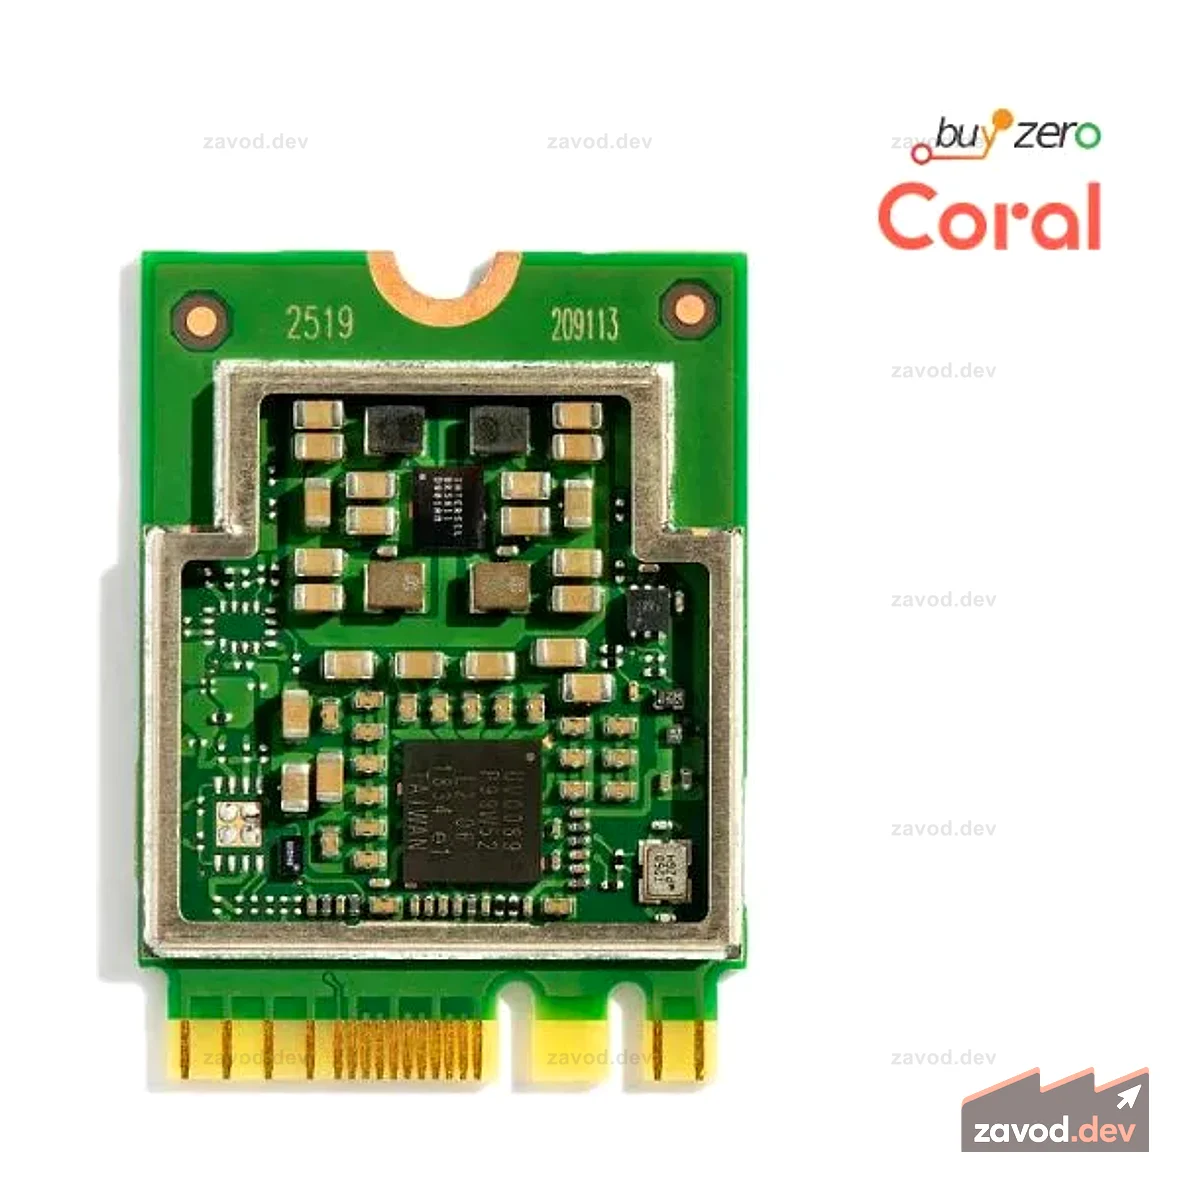
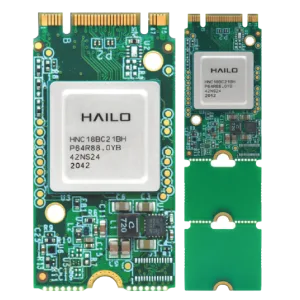
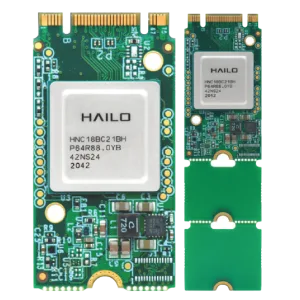
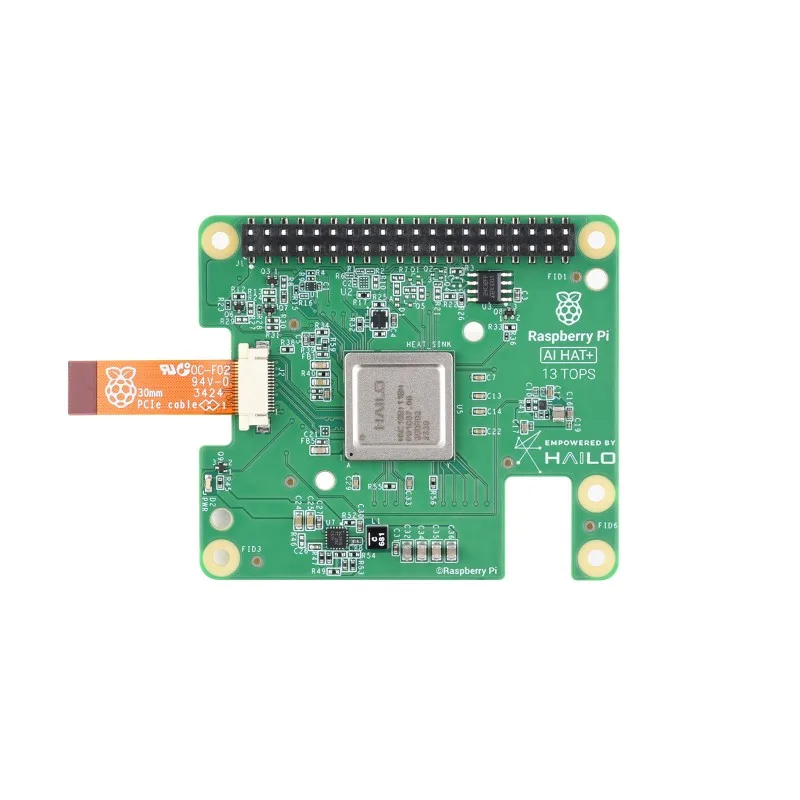
AI-ускорители и NPU — это специализированные модули и платы для разгрузки центрального процессора при инференсе нейросетей: USB- и M.2-ускорители (Google Coral, Hailo, Intel Movidius / Neural Compute Stick) и встраиваемые NPU.
При выборе учитывают производительность в TOPS, энергопотребление, форм-фактор (USB 3.0, M.2 A+E/M-key, mPCIe), поддерживаемые типы данных (INT8, FP16) и инструментарий компиляции моделей. Ускорители подключаются к SBC, edge-компьютеру или ПК и берут на себя свёрточные и тензорные операции, повышая FPS видеоаналитики при низком энергобюджете. Важна совместимость по интерфейсу и наличие драйверов под целевую ОС.
Применение — ускорение распознавания объектов, классификации, детекции дефектов и обработки нескольких видеопотоков на периферии без облака. Решение позволяет добавить AI-функции к существующему вычислителю без его замены. Аудитория — интеграторы видеоаналитики и разработчики edge-AI. Подбор по интерфейсу и моделям, отгрузка для юрлиц, доставка по России.
AI-ускорители и NPU (Neural Processing Unit) позволяют выполнять инференс нейросетей на порядок эффективнее, чем CPU. Выбор определяется задачей — будь то детекция объектов на конвейере, обработка речи или обучение моделей на edge-устройстве.
Ключевой показатель — пиковая производительность на целевой точности: TOPS (Tera Operations Per Second) при INT8 для инференса, TFLOPS при FP16/BF16 для дообучения. Уточните, какой тип операций преобладает: свёрточные сети (CNN) и трансформеры имеют разный профиль нагрузки, и одни ускорители оптимизированы под один тип, другие — под оба. Обратите внимание, что маркетинговые TOPS замеряются при разных условиях — сравнивайте только при одинаковой битности и одинаковом типе операций.
Для серверных и рабочих станций стандарт — PCIe (Gen3/Gen4/Gen5): чем выше полоса, тем меньше узкое место при передаче данных. Для встраиваемых систем используются M.2 (ключи M или B+M), USB 3.x и проприетарные шины. Модули на базе MIPI CSI/DSI актуальны для систем компьютерного зрения. Уточните TDP: серверный ускоритель с TDP 150+ Вт требует активного охлаждения и соответствующего блока питания, тогда как edge-модули могут укладываться в 5-15 Вт.
Критически важно наличие зрелого SDK и поддержка фреймворков: TensorFlow Lite, ONNX Runtime, PyTorch (через экспорт в TorchScript/ONNX), OpenVINO, TensorRT. Проверьте, есть ли официальная поддержка квантизации (INT8, INT4) и компилятора моделей. Для промышленных применений важна долгосрочная поддержка драйверов под Linux и наличие стабильного API — частые breaking changes увеличивают стоимость владения. Открытость документации и наличие примеров кода под вашу задачу сокращают время запуска.
Для встраиваемого применения на производстве уточните рабочий диапазон температур (industrial grade — как правило, -40...+85 °C), рейтинг защиты корпуса (IP54 и выше для запылённых сред). Для серверного развёртывания важны наличие ECC-памяти на борту, MTBF и наличие сертификатов CE/FCC. Масштабируемость через NVLink, PCIe-свитч или специализированные интерконнекты актуальна при построении кластеров.
Одноплатные компьютеры (Raspberry Pi, Rock Pi, Orange Pi) несут полноценную ОС Linux, гигабайты ОЗУ и интерфейсы Ethernet/USB3/HDMI — это база для машинного зрения и обработки данных. Микроконтроллеры (STM32, NXP, GD32, ESP32) работают без ОС в реальном времени, управляют периферией по I2C, SPI, UART, CAN и потребляют единицы милливатт. Для AI-инференса на краю берут SoM Jetson или Coral, а для жёсткой логики и опроса датчиков — промышленный MCU.
Ориентируйтесь на производительность в TOPS и поддержку фреймворка: NVIDIA Jetson (Orin Nano/NX) даёт от 20 до 100+ TOPS и работает с TensorRT, Google Coral на TPU оптимизирован под TensorFlow Lite (INT8, 4 TOPS), а FPGA-модули дают детерминированную задержку для кастомных пайплайнов. Учитывайте объём LPDDR, форм-фактор SO-DIMM или SMD и тепловой пакет — под нагрузкой модулю нужен радиатор или активное охлаждение.
Промышленные edge-компьютеры обычно несут изолированный RS485/RS232 с поддержкой Modbus RTU, порты Ethernet под Modbus TCP и OPC UA, дискретные входы/выходы (DI/DO) и CAN. Питание — широкий диапазон 9–36 В DC под автомобильные и шкафные сети, рабочий диапазон температур до -40…+70 °C. Для камер машинного зрения важны порты GigE Vision с PoE и USB3 Vision.
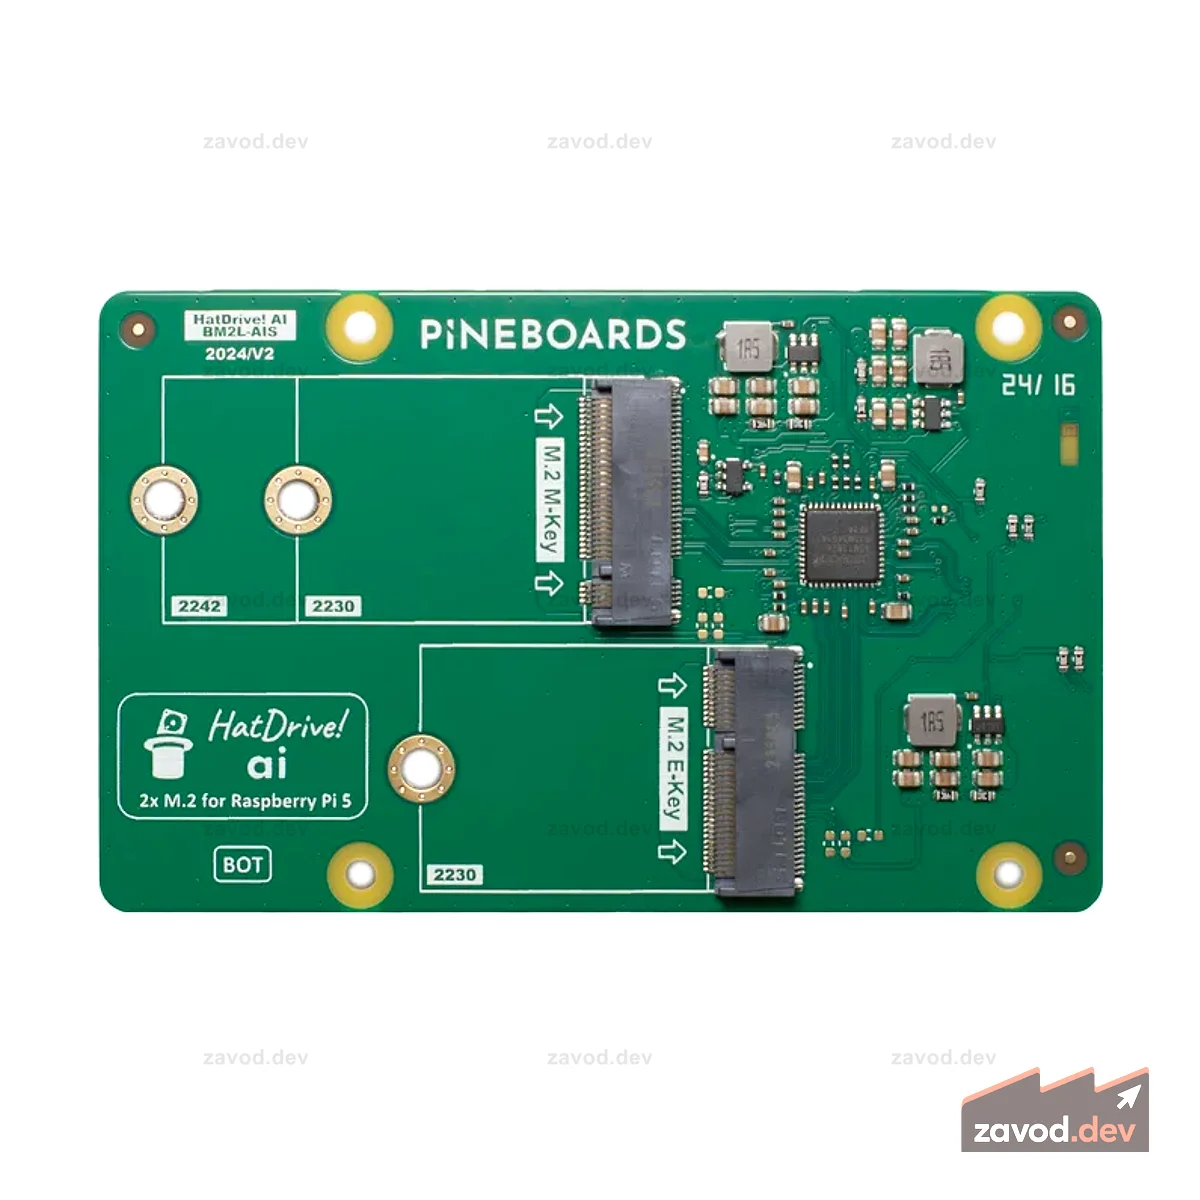
AI-ускоритель (NPU) разгружает CPU от матричных операций нейросети и поднимает FPS инференса в разы при том же энергобюджете. Внешние ускорители подключаются по USB3, M.2 (PCIe) или как HAT к одноплатнику; они дают единицы TOPS на INT8 и удобны, когда апгрейдить сам вычислитель нельзя. Для лёгких моделей детекции хватает встроенного NPU SoC, для тяжёлых сетей берут Jetson или дискретный ускоритель.
Для встраиваемых систем выбирают индустриальные microSD и eMMC с pSLC-режимом либо M.2/2242 NVMe SSD с расширенным температурным диапазоном и поддержкой power-loss protection. Объём ОЗУ (LPDDR4/LPDDR5) подбирают под модель: для классического CV хватает 4–8 ГБ, для крупных нейросетей нужно 16 ГБ и больше. Ресурс записи (TBW) критичен при постоянном логировании.
Да, отгружаем одноплатники, SoM Jetson/Coral, промышленные MCU и edge-компьютеры юридическим лицам по безналу с НДС, формируем коммерческое предложение и счёт. Позиции в наличии резервируются под заказ, по отсутствующим называем срок поставки. Доставка по России транспортными компаниями, отгрузочные документы в комплекте.
GPU — универсальный параллельный вычислитель с высоким TDP и широкой программной поддержкой. NPU — специализированная микросхема, оптимизированная под матричные операции нейросетей: при сопоставимой производительности на инференсе потребляет значительно меньше энергии. Для edge-устройств с ограниченным питанием NPU предпочтительнее; для гибкого прототипирования и обучения — GPU.
TOPS сами по себе не сравнимы без контекста: смотрите на битность (INT8, INT4, FP16), реальную латентность на вашей конкретной модели (публичные бенчмарки на MLPerf Inference) и пропускную способность памяти. Ускоритель с меньшим числом TOPS, но с быстрой памятью и хорошим компилятором может обгонять формально более мощного конкурента на вашей задаче.
Сначала фиксируют слот хоста и линии: PCIe Gen3/Gen4 x4/x8/x16 для карт, M.2 Key M/E/B (обычно PCIe x1–x4), mini PCIe или USB 3.2 для модулей. Проверяют габарит, высоту радиатора, питание от слота/разъема, поддержку DMA/IOMMU и драйвер под ОС.
Проверьте, принимает ли SDK ONNX/TFLite/TF или требует собственный IR, какие opset и слои поддержаны аппаратно. Важны режимы INT8/FP16/BF16, пер-канальная квантизация, статические/динамические shapes, NMS/Resize/Deconv. Неподдержанные операции часто уходят на CPU и ломают задержку.
Для edge-модулей TDP обычно 2–15 Вт, для M.2 и mini PCIe — до 25 Вт, для PCIe-карт — 25–75 Вт от слота и выше с 6/8-pin. Уточняют линии 3,3/5/12 В, пиковый ток, допустимую температуру кристалла, airflow, тип радиатора и наличие throttling при +60…+85 °C.